Telegram ChatGPT Poster - автопостинг на нейросети
Бот, который сам пишет посты через ChatGPT и публикует их в Telegram-канал, разбивая длинный ответ модели на читаемые сообщения в пределах лимитов мессенджера.
Проблема
Канал требует регулярных постов, а ответ языковой модели по формату не совпадает с форматом Telegram: он приходит одним куском, легко превышает лимит сообщения и разваливается на абзацах.
Результат
Бот генерирует текст по заданным параметрам, режет его на сообщения кратно абзацам, выдерживает паузу между отправками и публикует в канал - без участия человека.
Технологии
Обзор
Небольшой, но живучий инструмент: бот, который сам пишет посты через ChatGPT и публикует их в Telegram-канал. Задача звучала одной строкой - «сделать автопостинг на нейросети», - и вся содержательная работа оказалась не в генерации, а в стыковке двух форматов: того, как отвечает языковая модель, и того, как устроены сообщения в Telegram.
Демонстрация работы бота на YouTube
Проблема
Модель отдаёт текст одним куском произвольной длины. Telegram - мессенджер с жёстким лимитом на сообщение и своей типографикой, где стена текста не читается. Если публиковать ответ как есть, получаются две беды сразу: длинный ответ упирается в лимит и обрезается, а тот, что влезает, выглядит нечитаемым полотном.
Плюс два эксплуатационных вопроса, которые всегда всплывают на второй неделе работы: где хранить ключи API, чтобы менять их без правки скрипта, и как не отправлять сообщения подряд без пауз.
Решение
Бот принимает апдейты Telegram на собственный HTTP-сервер (порт задаётся в настройках), генерирует текст через OpenAI API и публикует результат в канал.
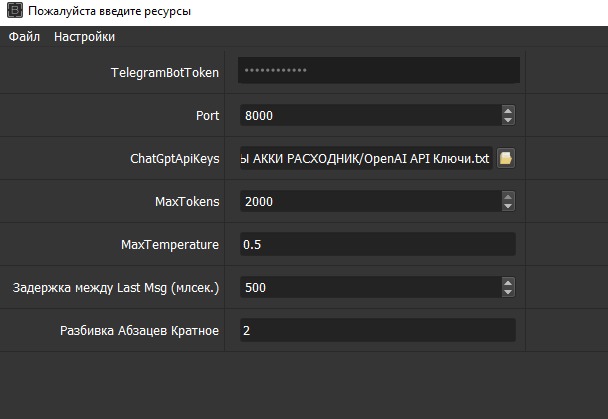
Ключевые параметры вынесены в окно ресурсов и меняются без правки логики: MaxTokens и MaxTemperature управляют объёмом и «температурой» текста, задержка между сообщениями в миллисекундах разводит отправки во времени, а кратность разбивки абзацев определяет, по сколько абзацев собирать одно сообщение. Именно последний параметр решает исходную проблему: длинный ответ модели превращается в серию читаемых сообщений, разрезанных по границам абзацев, а не по счётчику символов посреди слова.
Ключи OpenAI читаются из отдельного файла, а не хранятся в теле скрипта, - поэтому их можно заменить, не пересобирая бота.
Возможности
- Генерация постов через OpenAI API с настраиваемыми
MaxTokensиtemperature - Публикация в Telegram-канал через собственный webhook-сервер на заданном порту
- Разбивка длинного ответа на сообщения кратно абзацам - по смысловым границам, а не по счётчику символов
- Настраиваемая пауза между отправками сообщений
- Ключи OpenAI вынесены в отдельный файл и меняются без правки скрипта
- Все параметры задаются в окне ресурсов при запуске
Процесс разработки
Задача пришла в формулировке из одной строки, и первая версия сделала ровно то, что просили: спросила модель, отправила ответ. Развалилось это на первом же длинном тексте.
Дальше работа свелась к тому, чтобы описать формат Telegram в параметрах, а не зашивать его в код. Разбивка кратно абзацам вместо разрезания по символам - единственный способ не порвать текст посреди мысли. Пауза между сообщениями нужна, чтобы серия постов не уходила одним залпом. Оба значения вынесены в настройки, потому что «правильная» разбивка зависит от канала и от того, какие тексты он публикует, и подбирается на практике.
Результаты
- Канал наполняется без участия человека: генерация и публикация идут одной цепочкой
- Длинные ответы модели больше не упираются в лимит сообщения и не превращаются в стену текста
- Формат публикации настраивается под канал параметрами, без правки скрипта
- Ключи и токены отделены от логики и меняются в окне ресурсов
Выводы
Кейс маленький, но показательный: основная работа в «сделайте автопостинг на ChatGPT» лежит не на стороне ChatGPT. Сгенерировать текст - один вызов API. Сделать так, чтобы этот текст выглядел как нормальный пост в конкретном канале, - это разбивка, паузы, лимиты и параметры, которые подбираются на реальных публикациях.
Та же граница между «модель ответила» и «продукт работает» видна и в более крупном проекте портфолио - Astrogenerator, где на подгонку текста под формат Telegram и вкус заказчика ушло две недели из шести.
Услуги в этом проекте
Похожие кейсы
- Neurox - AI-бот генерации фото и видео во ВКонтактеБот для сообщества ВК, который превращает текст и фото в картинки и видео: 12 нейросетей в одном диалоге, оплата через ЮKassa и панель владельца с выручкой, себестоимостью и маржой каждой генерации.
- Astrogenerator - Telegram-бот генерации гороскоповТрипваер-бот для практикующего астролога: сам пишет общий и персональный гороскоп на ChatGPT, сам рисует карточку лунного дня и прогревает подписчика к индивидуальной работе.